在"东数西算"工程持续推进的背景下,贵州作为全国一体化算力网络国家枢纽节点之一,聚集了大量数据中心、云计算与软件服务企业。对于本地及周边省份的政企客户来说,找一家靠谱的贵州大数据公司,已经不只是"做个系统"这么简单,而是关系到数据资产能否真正沉淀、业务流程能否被数据驱动。本文结合信息传输、软件和信息技术服务业的实际项目经验,梳理一套可落地的选型思路,帮助企业少走弯路。
一、先搞清楚:你需要的是哪一类大数据服务
很多企业在接触服务商之前,对自身需求只有一个模糊的印象——"我们要做大数据"。但大数据是一个很宽的概念,不同服务商的能力侧重点差异极大。建议先对照下面几类常见需求做自我诊断:
- 数据平台开发:需要从零搭建统一的数据接入、存储、计算与服务平台,支撑多个业务系统。
- 数据中台建设:已有若干业务系统,但数据孤岛严重,希望沉淀公共数据服务能力,供前台快速调用。
- 数据可视化大屏:面向领导驾驶舱、指挥中心、展厅等场景,强调实时性与视觉呈现。
- BI报表系统开发:面向业务部门的自助分析、固定报表、指标监控。
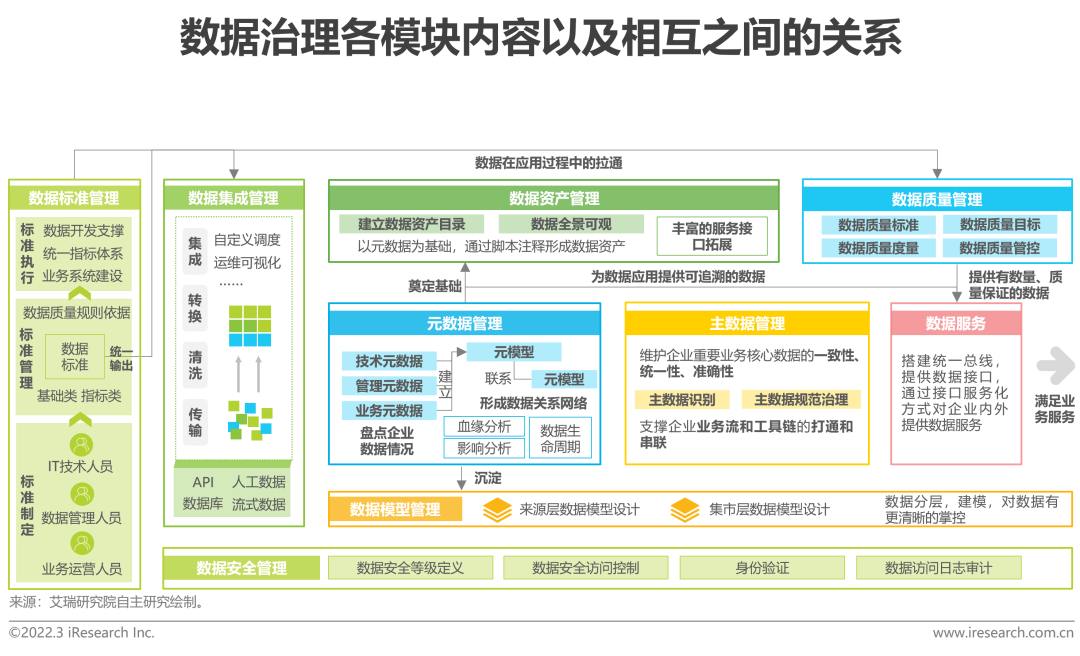
- 数据治理服务:元数据、数据标准、数据质量、主数据、数据安全等体系化建设。
- 企业数据仓库建设:分层建模、指标体系梳理、历史数据整合。
- 数据采集接口开发与API数据对接:多源异构系统的数据打通,包括数据库、文件、消息队列、第三方接口。
- 实时数据计算:对流式数据做秒级处理,如设备监控、风控预警、实时推荐。
- Hadoop集群搭建与运维:底层基础设施的规划、部署与调优。
把需求归类清楚之后,再去评估服务商,沟通效率会高很多,也不容易被"什么都能做"的话术带偏。
二、评估贵州大数据公司的五个硬指标
1. 技术栈的完整度与深度
一个完整的大数据项目,通常涉及数据采集、存储、计算、调度、治理、服务、可视化七个环节。靠谱的团队应当能说清楚自己在每个环节用什么技术、为什么这么选。例如离线计算用Hive还是Spark SQL,实时链路用Flink还是Storm,消息中间件选Kafka还是Pulsar,元数据管理是自研还是基于开源二次开发。能把这些讲明白的团队,通常做过真正落地的项目。
2. 是否具备行业场景理解能力
信息传输、软件和信息技术服务业的项目往往带有强烈的行业属性。政务、能源、交通、制造、医疗的数据模型和指标体系完全不同。选型时要重点看服务商是否有同行业案例,能否在需求调研阶段就提出有价值的指标建议,而不是被动地"你说什么我做什么"。
3. 交付方式:项目制还是产品化
纯项目制交付灵活但成本高、周期长;纯产品化交付快但适配性有限。多数优质服务商采用"平台产品+行业定制"的混合模式,既有可复用的数据中台底座,又能针对客户业务做二次开发。这种模式在预算和周期上通常更可控。
4. 数据安全与合规能力
数据安全法、个人信息保护法实施后,数据分级分类、脱敏加密、访问审计已成为硬性要求。评估时要确认服务商是否具备等保测评配合经验、是否支持字段级权限控制、是否有完整的数据血缘追踪能力。
5. 运维与持续服务能力
大数据平台不是交付即结束,集群监控、任务调度异常处理、性能调优、版本升级都是长期工作。建议在合同中明确SLA响应时间、驻场支持方式以及知识转移计划,避免"上线即失联"。
三、常见误区:这些坑要提前避开
- 只看大屏效果,不看底层数据质量。炫酷的可视化大屏如果数据来源不可靠、口径不统一,反而会误导决策。大屏是"果",数据治理才是"因"。
- 盲目追求全量实时。并非所有数据都需要实时计算,实时链路的技术复杂度和成本远高于离线批处理。应按业务时效要求分级设计,T+1能解决的不要上秒级。
- 忽视指标体系设计。指标口径不统一是数据项目失败的高频原因。建议在项目初期就建立指标字典,明确每个指标的业务定义、计算逻辑和责任部门。
- 低估数据治理的长期性。数据治理是持续运营工作,不是一次性项目。选型时要看服务商能否提供治理方法论和配套工具,而不仅是人力外包。
四、从需求到落地:一个典型的实施路径
以数据中台建设为例,成熟的项目通常按以下阶段推进:
- 现状调研与蓝图规划:梳理现有系统、数据源、业务流程,输出数据架构蓝图。
- 基础设施搭建:根据数据量级和并发要求,规划Hadoop/Spark集群或云上数据湖方案。
- 数据采集与接入:通过接口开发、CDC同步、文件抽取等方式完成多源数据汇聚。
- 数仓分层建模:按ODS、DWD、DWS、ADS分层建设,形成规范的主题域模型。
- 指标与标签体系:沉淀公共指标和标签,形成可复用的数据资产。
- 数据服务化:通过API网关对外提供数据服务,支撑BI报表、大屏和业务系统调用。
- 治理与运营:建立元数据管理、质量监控、权限管控和运维保障机制。
这个路径并非固定模板,实际项目中会根据客户成熟度做裁剪,但核心逻辑——先有数据、再有模型、最后有服务——是通用的。
五、给选型者的实操建议
在贵州本地寻找大数据服务商时,建议按以下步骤推进:
- 准备一份简明的需求说明,包含业务目标、数据源清单、期望上线时间和预算区间。
- 要求候选服务商提供同行业案例,并允许与案例客户做背景沟通。
- 安排技术方案答辩,重点考察架构设计合理性和技术选型理由。
- 做小范围POC验证,用真实数据跑通一条完整链路,比看PPT更有效。
- 在合同中约定验收标准,包括功能清单、性能指标和文档交付物。
贵州的大数据产业生态已经相对成熟,从底层算力到上层应用都有服务商分布。选对合作伙伴的关键,不在于对方规模多大,而在于其技术能力是否匹配你的业务阶段,交付方式是否可持续。把需求想清楚、把指标定明白、把验收写具体,项目成功的概率会大幅提升。
六、结语
数据价值的释放是一个渐进过程,从数据采集接口开发、企业数据仓库建设,到数据中台、BI报表系统与数据可视化大屏,每一步都在为后续的智能应用打基础。对于正在寻找贵州大数据公司的企业而言,与其追求"一步到位"的宏大方案,不如选择一家能陪你分阶段落地、持续迭代的技术伙伴。毕竟,数据平台的生命力不在于上线那天有多亮眼,而在于三年后是否仍在稳定支撑业务决策。