贵州作为国家大数据综合试验区,近年来聚集了大量大数据企业,从数据存储、清洗加工到平台开发、行业应用,产业链条日趋完整。对于本地及周边地区的政企单位来说,选择一家靠谱的贵州大数据公司,往往决定了数据项目能否真正落地见效。但面对众多服务商,如何判断其技术实力与服务匹配度?本文从业务场景出发,梳理选型时值得重点考察的几个维度。
一、先厘清需求:你要的是平台、中台还是报表?
很多项目在启动阶段就容易走偏,原因在于需求边界模糊。大数据服务大致可分为几类:
- 大数据平台开发:包括Hadoop集群搭建、数据采集接口开发、实时数据计算等底层能力建设,适合数据量大、需要自主可控技术栈的单位。
- 数据中台建设:强调数据资产沉淀与复用,打通业务系统之间的数据孤岛,为上层应用提供统一的数据服务。
- 数据可视化大屏与BI报表系统开发:面向管理决策与业务监控,侧重展示效果与交互体验。
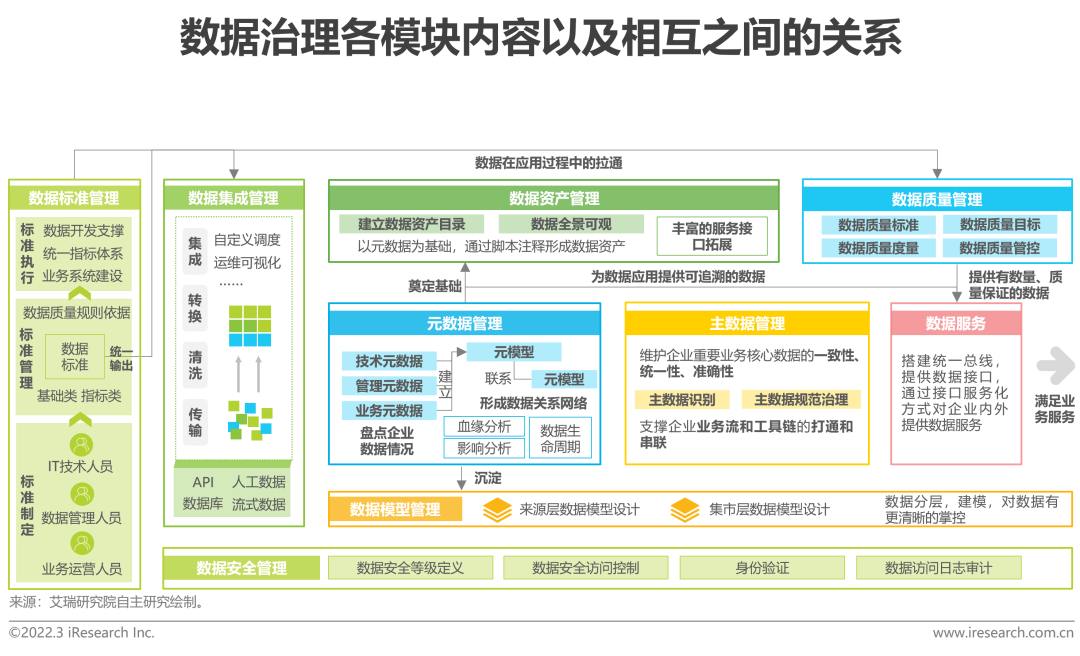
- 数据治理服务与企业数据仓库建设:解决数据标准不统一、质量参差、口径混乱等问题,是数据价值释放的前提。
不同需求对应的技术栈、团队配置和交付周期差异很大。选型前先把这些问题想清楚,才能避免被服务商的"全能"话术带偏。
二、考察技术栈的完整度与开放性
一家成熟的贵州大数据公司,通常需要具备从数据采集、存储、计算到应用层的全链路能力。具体可以关注几个技术细节:
- 是否支持多种数据源接入,API数据对接能力是否成熟,能否兼容关系型数据库、消息队列、文件系统等异构数据源;
- Hadoop、Spark、Flink等组件的集群搭建与调优经验,是否有实际生产环境案例;
- 实时数据计算链路是否完整,从采集到指标输出延迟能否满足业务要求;
- 平台是否具备开放性,避免形成新的技术锁定,后续能否与自有系统平滑集成。
技术栈的完整度不是看宣传册上列了多少名词,而是看团队能否说清楚每个组件在项目中的实际作用,以及遇到性能瓶颈时的解决思路。
三、数据治理能力是分水岭
不少单位在完成平台建设后发现,数据虽然存下来了,但用起来依然困难:指标口径不一致、重复建设、数据质量无法追溯。这正是数据治理服务的价值所在。评估一家服务商的数据治理能力,可以重点看三个方面:
一是是否具备成体系的数据标准管理方法,包括主数据管理、元数据管理、数据质量管理;二是是否有落地的数据仓库分层设计,能否把ODS、DWD、DWS、ADS各层职责划分清楚;三是治理工具是否与开发流程结合,而不是停留在文档层面。真正做过治理项目的团队,往往能拿出具体的口径梳理清单和质量规则样例。
四、可视化与BI:别只看"好看"
数据可视化大屏和BI报表系统是很多项目的"门面",也是容易被过度包装的环节。选型时建议关注:大屏在高分辨率下的适配能力、图表组件是否支持自定义扩展、BI系统是否支持自助式分析而非固定报表、权限体系是否细致到行级和字段级。此外,前端渲染性能在数据量较大时是否稳定,也是实际使用中经常暴露问题的点。
五、本地化服务与持续运维同样重要
大数据项目不是一次性交付,后续的运维、调优、需求迭代往往占据更长周期。贵州本地的服务商在响应速度、现场支持、行业理解上通常更有优势。选型时可以了解对方是否有稳定的运维团队、是否提供系统集成与技术支持的一站式服务、故障响应机制如何。对于政务和行业客户而言,数据安全与合规能力也应纳入考察范围,包括权限审计、数据脱敏、传输加密等细节。
六、看案例,更要看案例的"深度"
案例数量不等于项目质量。建议重点了解服务商在相似行业、相似数据规模下的实际交付情况,比如是否独立完成过Hadoop集群搭建与调优、是否承接过跨系统API数据对接、数据中台上线后实际支撑了多少个业务应用。有条件的话,可以要求对方讲解一个完整项目的架构演进过程,这比罗列客户名单更能反映真实水平。
总的来说,选择贵州大数据公司,核心是让技术能力与业务需求精准匹配。从平台开发、数据中台到治理与可视化,每个环节都有其专业门槛。建议在选型阶段多轮沟通、明确验收标准,把需求文档和技术方案做扎实,项目落地才有保障。